TT の流量上限と再接続── REST の利用プランと FIX の自動回復を前提に設計する
TT REST API の上限はアプリケーションキーごとの利用プランで決まり、FIX のセッションは週に 1 度リセットされ、再接続すると未送信の約定が自動で届きます。公開資料の数値と動作をもとに、発注・照会の処理をどう組むかを整理します。
金融システムの可用性は、しばしば「九が何個並ぶか」で語られます。ただ、この数字を掲げるだけでは設計は決まりません。何をもって停止とみなすのか、どの範囲を対象とするのか、そして超過したときに何をするのかまで含めて初めて、アーキテクチャの選択に接続されます。
本稿では、可用性目標を出発点として、冗長化、依存関係、データ保護をどう決めていくかを整理します。金融庁が公表している分析レポートで示された障害の類型と留意事項も参照し、規制側が何を見ているかを踏まえた設計に落とします。参照した一次資料は末尾に列挙しています。
可用性の目標は、そのまま「年間・月間で何分止まってよいか」に翻訳できます。この翻訳を先にやっておくと、目標が現実的かどうかの感覚が持てます。
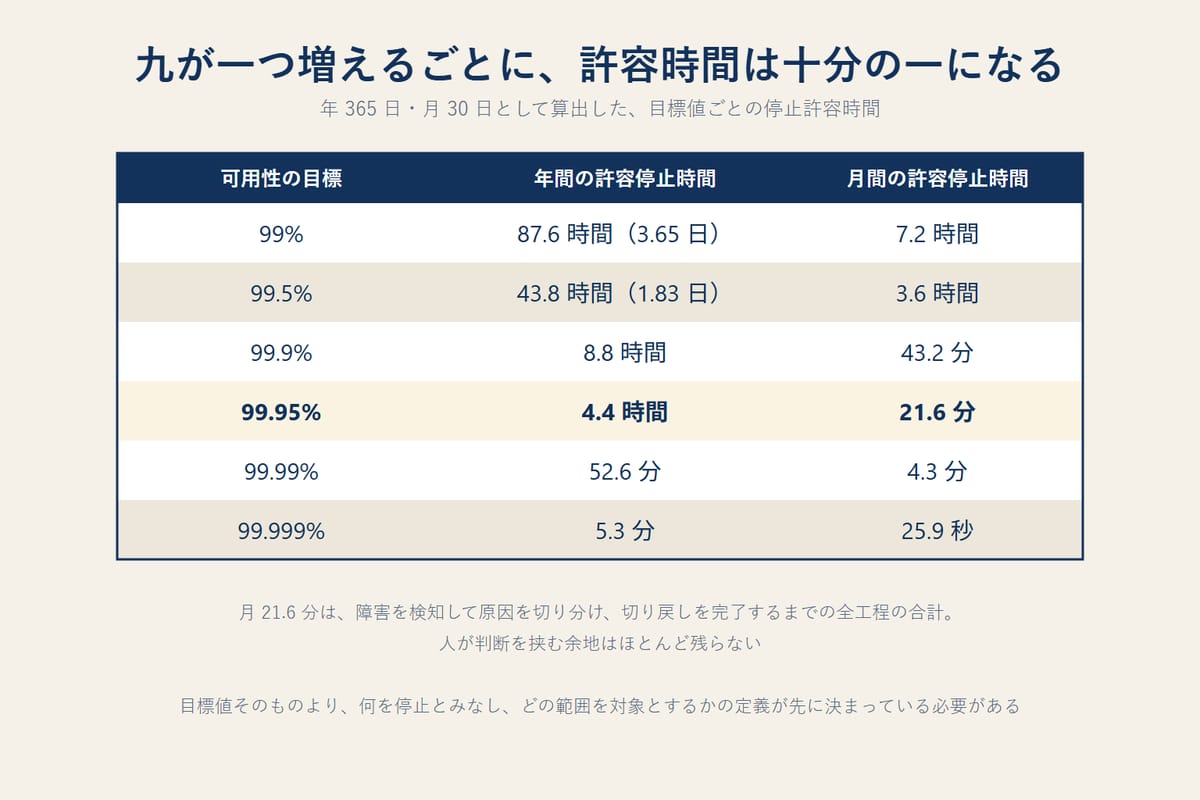
99.95% は月あたり 21.6 分です。これは障害を検知し、原因を切り分け、切り戻しを完了するまでの全工程の合計であって、復旧作業に使える時間ではありません。人が状況を把握して判断を下す余地は、この段階でほとんど残りません。目標を一段上げるという意思決定は、運用を自動化する意思決定とほぼ同義です。
数字の前に、何を停止とみなすかを定義する必要があります。プロセスが生きていても業務が回っていない状態はよくあり、ヘルスチェックが通ることと利用者が取引できることは別です。実務では、利用者から見た成功率と応答時間を指標に置くのが現実的で、インフラの死活ではなく業務の成否で測ることで目標が設計に接続されます。
この整理は、金融庁がオペレーショナル・レジリエンスの基本動作として示している順序と一致します。同庁のモニタリングでは、まず「重要な業務」を特定し、次に「耐性度」を設定し、相互連関性のマッピングと必要な経営資源の確保を経て、適切性を検証するという流れが基本動作として整理されています。耐性度は「いつまでに」と「どの程度まで」の二つを基準に設定する取組事例が挙げられており、単一の数字ではありません。
対象範囲も明示します。計画メンテナンスを含めるか、上流の金融ネットワーク側の障害を含めるか、片方の機能だけが縮退した状態をどう数えるか。ここが曖昧なままだと、事後に「あれは停止に当たるのか」という不毛な議論になります。
冗長化の議論は単一障害点を潰す方向に進みがちですが、実際には障害の相関を見るほうが有益です。同一のアベイラビリティゾーンに置いたインスタンスを増やしても、ゾーン全体の障害には効きません。同じ設定変更を全ノードへ一斉に配れば、冗長化は無力です。
この点は現場の実感にとどまりません。金融庁の分析レポートは、日常の運用・保守の過程で発生する障害の類型として「冗長構成が機能しない等の障害」を明示的に挙げ、冗長構成の設定に関する手順書の整備、意図どおりに機能することの実効性確保、そして機能しなかった場合の業務継続態勢の整備を対応として示しています。冗長構成は入れた時点で完了ではなく、意図どおり動くことを確かめ続ける対象だという整理です。
マルチリージョン構成は強力ですが、コストと複雑さが跳ね上がります。整合性を保ったままリージョンをまたぐ書き込みを行うと応答時間が悪化するため、まずは単一リージョン内のゾーン分散で目標に届くかを検討し、規制や事業継続の要求から必要な場合に限ってリージョン分散へ進むのが順当です。
切り替えを自動にするか手動にするかも慎重に決めます。自動切り替えは復旧時間を短くする一方、誤検知による不要な切り替えのリスクを伴います。金融の記帳系では切り替え自体が事故になりうるため、判断を人に残す構成も合理的な選択です。いずれの構成でも、切り替え後に元へ戻す手順まで含めて設計します。フェイルオーバーは訓練していてもフェイルバックの手順が曖昧なまま残り、切り替えたまま長期間運用するという状態を招きがちです。
分散システムでは、ネットワーク分断が起きたときに整合性と可用性の両方を保つことはできません。重要なのは、この選択を機能ごとに分けて事前に決めておくことです。
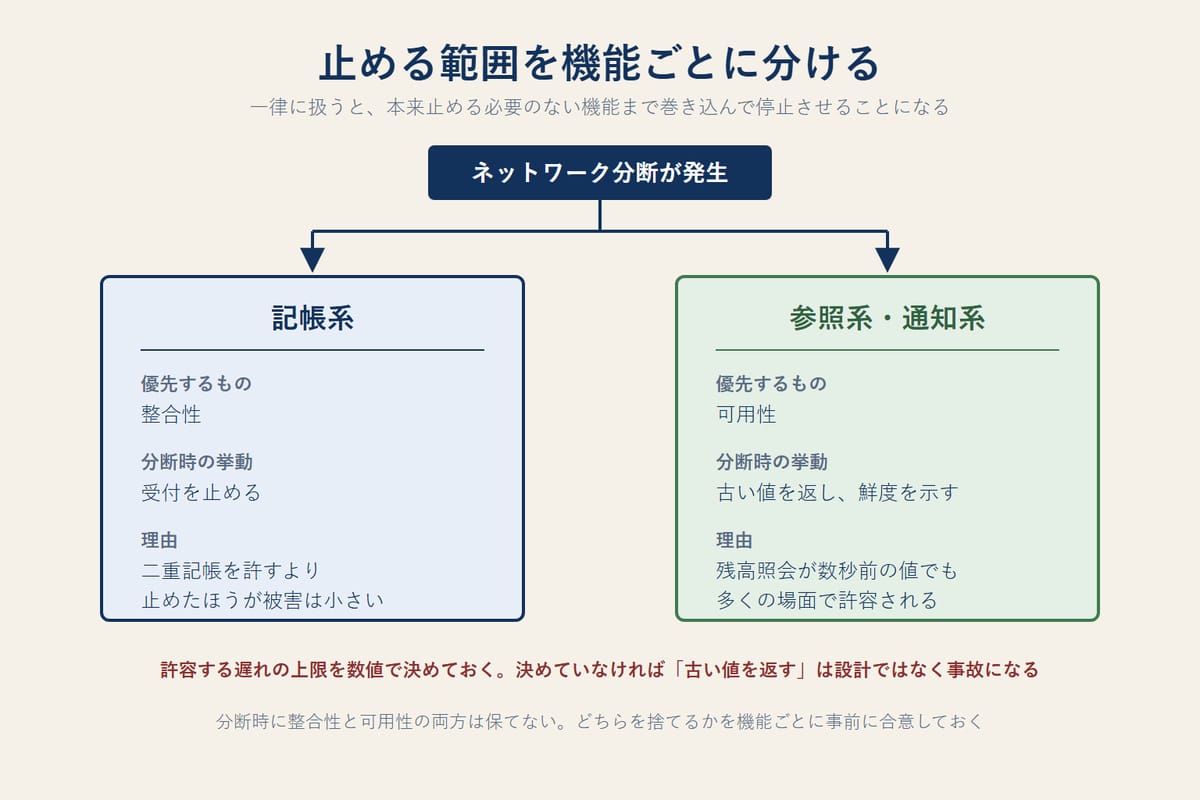
勘定に関わる処理は整合性を優先し、分断時は受付を止める判断が基本です。二重記帳を許すくらいなら止めたほうが被害は小さいためです。一方、参照系や通知系は可用性を優先して構いません。残高照会が数秒前の値を返すことは、多くの場面で許容されます。
ただし「古い値を返す」を設計として成立させるには、許容する遅れの上限を数値で決め、利用者に鮮度を示す必要があります。上限を決めないまま古い値を返す実装は、設計ではなく事故です。
自社の設計をどれだけ丁寧に作っても、依存先の可用性を超えることはできません。直列に依存する要素が増えるほど、全体の可用性は積として下がります。
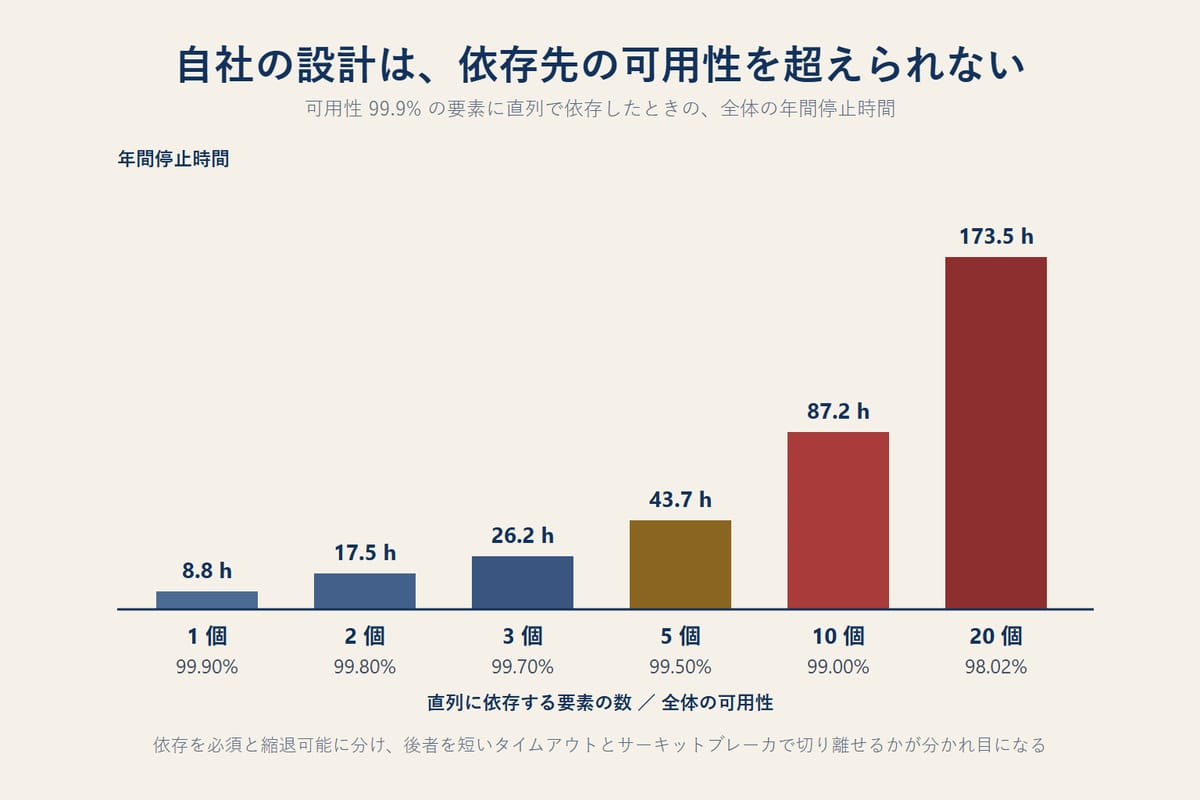
ここで効くのが、依存を必須依存と縮退可能な依存に分類する作業です。認証基盤のように落ちたら何もできないものと、補助的な機能のように落ちても本体は動くものを分け、後者は呼び出しに短いタイムアウトとサーキットブレーカを入れて切り離せるようにします。この分類をしないまま依存を増やすと、上のグラフの右側へ静かに移動していきます。
見落とされやすいのが、制御系への依存です。設定配布の仕組み、名前解決、証明書の発行、コンテナイメージの取得といった要素は平常時には意識されませんが、障害時にはこれらが動かないと復旧作業そのものが進みません。復旧手順が外部サービスに依存していないかは、事前に確認しておく価値があります。
依存の可視化には、実際の通信から関係を起こす方法が有効です。設計図に描かれた依存関係と稼働中の実態はしばしば食い違います。分散トレーシングで観測された呼び出し関係を定期的に出力し、想定と違う経路が生まれていないかを確認すると、いつの間にか増えた依存に気づけます。
金融庁の分析レポートによれば、8割を超える金融機関でクラウドサービスが利用され、基幹系システムへの採用や検討も進んでいます。同庁はクラウドサービス事業者との対話を行い、障害対応の観点で留意すべき点を四つ示しています。
第一に、クラウドサービスを外部委託として管理し、その特性に由来するリスクを考慮した対策を講じること。第二に、障害対応に必要な情報をオンプレミスの場合と同程度に迅速に取得できるかを、あらかじめ確認しておくこと。第三に、パブリッククラウドに起因する障害として想定以上に深刻なシナリオを具体的に設定し、金融機関と事業者がともに机上演習を行うこと。第四に、それを通じて対応可能かを検証し、インシデント対応計画やコンティンジェンシープランを整備・更新することです。
実装の観点で重いのは第二の点です。事業者側の障害では、原因も復旧見込みも自社では観測できません。自社の監視でどこまで切り分けられるか、事業者からどの粒度の情報がどれだけ早く来るのかを、契約と運用の両面で事前に確認しておく必要があります。同レポートは、同一のクラウドを利用する複数の金融機関が共同で演習を行うことも有効だとしています。
可用性の設計とデータ保護の設計は、しばしば混同されます。冗長構成があればデータは守られると考えがちですが、複製は誤った書き込みも忠実に複製します。アプリケーションの不具合や誤操作でデータが壊れた場合、冗長化は助けになりません。
必要なのは、時間をさかのぼれる仕組みです。バックアップの取得間隔は、失っても許容できるデータ量から逆算します。ここで復旧できることを実際に確認する工程が要ります。取得できていても復元できないバックアップは珍しくなく、定期的な復元試験を運用に組み込んでおく必要があります。
金融システムでは、記帳を追記のみとし、状態を導出可能にしておく方法も有効です。過去の状態を再構成できるため、誤った処理の影響範囲を特定しやすく、訂正も追記として記録できます。監査への説明もしやすくなります。
可用性は、障害の発生頻度と復旧時間の積で決まります。発生をゼロにはできない以上、復旧時間の短縮への投資は費用対効果が高くなります。
効くのは地味な要素です。障害を検知するまでの時間、原因の切り分けにかかる時間、切り戻しの実行時間。このうち検知と切り分けは、ログとメトリクスとトレースが相関して追えるかどうかで大きく変わります。取引の識別子が全レイヤのログに乗っていれば、どの工程で失敗したかを短時間で特定できます。切り戻しは実際にやってみないと所要時間が分からないため、定期的に本番相当の環境で実行し、手順書と実態のずれを潰しておきます。
あわせて、エラーバジェットの考え方を運用に持ち込むと、可用性と開発速度の綱引きが数値で扱えるようになります。99.95% であれば月 21.6 分が予算です。予算が残っているうちは変更を進め、使い切ったら安定化を優先する。この運用は、可用性の議論を精神論から切り離す効果があります。
障害の振り返りでは、個人の不注意に原因を求めない姿勢を明示しておきます。手順を誤ると事故になる仕組みが残っていること自体が問題であり、そこを直さない限り同じ事象は再発します。振り返りの結論が再発防止策として仕組みに落ちているかを次の振り返りで確認する運用にすると、対策が形骸化しません。
可用性の目標は、数字を掲げるところではなく定義を決めるところから始まります。業務の成否で測り、耐性度を「いつまでに」と「どの程度まで」で設定し、機能ごとに整合性と可用性の優先順位を分け、依存関係を必須と縮退可能に切り分ける。冗長構成は入れた時点ではなく、意図どおり機能することを確かめ続けて初めて効きます。
クラウドを使う場合は、障害対応に必要な情報を自社でどこまで取得できるかを事前に確認し、深刻なシナリオで演習しておくことが要になります。そのうえで、発生の抑制と同じだけ復旧時間の短縮に投資する。この積み重ねが、結果として高い可用性につながります。
金融テクノロジー総合研究所では、クラウド・マイクロサービス構成の設計レビュー、SRE とオブザーバビリティの導入支援、金融システムの開発伴走を受託しています。現行構成の評価からご相談いただけます。お問い合わせよりご連絡ください。
FTL の技術スタックと受託開発の進め方は FTLの技術とは? にまとめています。
 インフラ
TT REST API の上限はアプリケーションキーごとの利用プランで決まり、FIX のセッションは週に 1 度リセットされ、再接続すると未送信の約定が自動で届きます。公開資料の数値と動作をもとに、発注・照会の処理をどう組むかを整理します。
 インフラ
J-GATE には、注文を拒否する、取消を受け付けない、注文の出し方を月次で判定する、取引を一時中断する、という複数の仕組みがあります。それぞれを発注処理のどこで扱うかを整理します。
 インフラ
Workspace 経由・クラウド直結・社内配信基盤のどれで接続するかで、必要な資格情報は変わります。App Key と ID の役割、認証方式 V1 と V2 の違い、同じ ID を 2 か所で使うと切れる問題を整理します。