金融LLMの「幻覚」問題にどう向き合う?── 精度と信頼性のジレンマ
幻覚をなくすのではなく、誤りが業務判断へ流れ込まない構造を作る。誤りの類型と、金融庁が示した四つの局面を突き合わせます。
決算短信や有価証券報告書からシグナルを取り出す試みは、機械学習の応用としては古くから続いてきた領域です。辞書ベースの極性判定から始まり、単語の分散表現、事前学習済みの言語モデルへと手法が移り、いまは大規模言語モデルを前提とした設計が主流になりつつあります。
手法が置き換わるたびに何かが良くなり、同時に別の難しさが現れました。実際に金融テキストの分析基盤を作り替えてきた立場から、何が変わって何が変わっていないのかを整理します。参照した一次資料は末尾に列挙しています。
初期に広く使われたのは、肯定的な語と否定的な語を並べた辞書で文書のトーンを測る手法です。ここで重要なのは、汎用の感情辞書がそのままでは使えないという点が実証的に示されていることです。
Loughran と McDonald は 2011 年の研究で、1994年から2008年の 10-K の大規模なサンプルにおいて、広く使われていた汎用の心理社会辞書が否定的と判定した語のおよそ四分の三が、金融の文脈では通常は否定的とみなされない語だったと報告しています。liability(負債)、cost(費用)、tax(税)といった、開示文書では中立的に使われる語が否定語として数えられていたためです。金融文書向けに調整された辞書がいまもベースラインとして意味を持つのは、この差が大きいからです。
それでも辞書ベースの限界は明確で、否定や条件節を扱えません。「減益懸念は後退した」という文は否定的な語を含みますが、内容は肯定的です。「想定の範囲内」「概ね計画通り」といった婉曲表現も、一般的な語彙としては中立ですが開示の文脈では含意を持ち、辞書に金融特有の語を追加しても捉えきれませんでした。
一方で残る利点もあります。結果が完全に説明できる点です。どの語が判定に寄与したかを一意に示せるため、なぜこのスコアになったのかという問いに即答できます。この性質は、モデルを刷新した後も比較対象として保持する価値があります。
大規模言語モデルを導入して明確に改善したのは、分類そのものより前段の工程でした。具体的には、文書の構造化です。決算資料は企業ごとに見出しの付け方や項目の並びが異なり、従来は企業別の抽出ルールを書き続ける必要がありました。
この作業が大きく減りました。定義した項目に対して該当箇所を拾わせる用途では、表記の揺れをある程度吸収してくれます。新しい企業を対象に加えるときの立ち上げ工数が下がったことが、実務では最も効いた変化でした。もう一つは長文の要約で、中期経営計画のような文書から論点を抽出する下読みを任せられるようになりました。ただし、これは絞り込みの用途に限るという前提つきです。
金融分野の日本語ベンチマークは整備が進んでいます。Preferred Networks が公開している japanese-lm-fin-harness は、有価証券報告書を対象とした感情分析(chabsa)、証券アナリストの基礎知識、公認会計士試験の監査、ファイナンシャル・プランナー 2 級、証券外務員一種の五つのタスクで構成され、正答率で評価します。
ここで注意が要るのは、これらの多くが選択式で知識を測る設計だという点です。モデルが金融の用語や制度をどれだけ知っているかは分かりますが、自社が定義した項目を開示文書から取りこぼしなく抽出できるかは測っていません。ベンチマークの順位が上がったからといって、自社のパイプラインの抽出率が上がる保証はありません。
結局、自社の文書と自社の項目定義で作った評価セットを持たない限り、モデルの入れ替えを判断できません。この評価セットの整備は地味ですが、モデルが次々に更新される状況ではむしろ資産になります。
期待していたほど改善しなかった部分もあります。第一に、数値の正確な取り扱いです。表形式のデータから正しい値を取り出す作業は、依然として構造化された抽出処理のほうが確実です。言語モデルに表を読ませると、似た数値の取り違えが一定の頻度で起こります。
第二に、ラベルの定義そのものの難しさです。ある開示が肯定的か否定的かという判定は、何を基準にするかで答えが変わります。株価への影響を基準にするのか、業績への影響を基準にするのかで正解が入れ替わる事例が出てきます。手法を変えても、この曖昧さは残ります。
第三に、評価の難しさです。テキストから得たシグナルが運用成果につながるかを検証するには、結局のところ時点管理されたデータと厳密なバックテストが要ります。前段の精度が上がっても、検証の厳密さを要求する部分は何も減りません。
いくつか作り直した結果、現在は工程を分ける構成に落ち着いています。
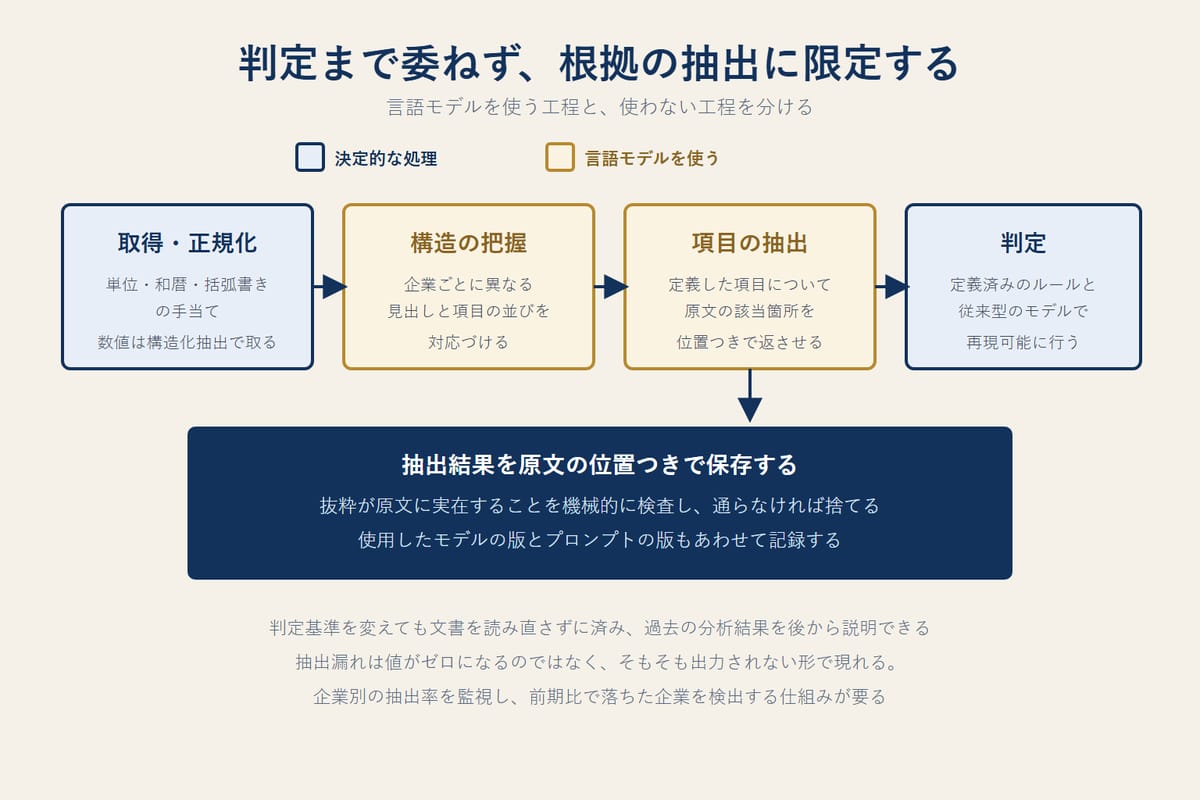
言語モデルには、判定結果ではなく原文中の該当箇所を位置つきで返させます。返ってきた抜粋が原文のその位置に実在するかを機械的に検査し、通らなければ捨てます。この検査を入れておくと、原文にない文言が混ざる事故を工程の内側で止められます。
この分離には二つの利点があります。判定基準を変えたときに文書を読み直さずに済むこと、そして抽出結果が原文に紐づいているため後から検証できることです。運用に入ってから効いてくるのは、この検証可能性のほうでした。
日本語を扱ううえで、いくつか固有の手当てが必要でした。いずれも例外を投げずに通ってしまう種類の問題です。
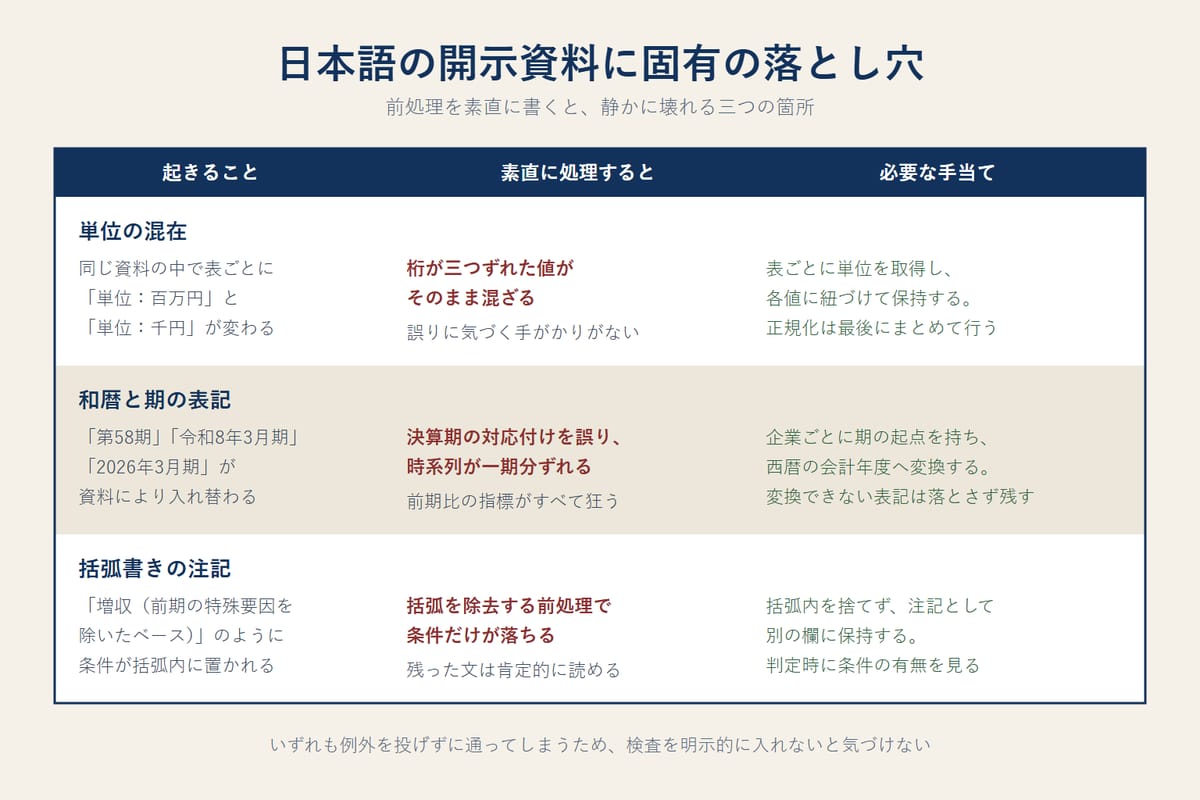
とくに厄介なのが括弧書きです。日本語の開示文書では注記や補足が括弧内に置かれ、その中に条件が書かれていることがあります。括弧を単純に除去する前処理を入れると条件だけが落ち、残った文は肯定的に読めてしまいます。前処理の一行が判定を反転させる例として、この種の処理は必ず具体例で検証します。
取得の段階にも前提があります。有価証券報告書を機械的に取得する EDINET の API は購読キーを要求するため、利用登録と鍵の管理が最初の作業になります。取得元ごとに認証方式も更新頻度も異なるので、この層は早めに一本化しておくと後が楽になります。
基盤を動かし続けてみると、精度以外の要素が想像以上に重要でした。もっとも手を焼いたのは、開示の様式変更への追随です。企業が資料の構成を変えると抽出が崩れますが、崩れたことに気づく仕組みがないと、静かに欠損が増えます。
いまは、抽出率の推移を企業別に監視し、前期比で大きく落ちた企業を検出する仕組みを入れています。抽出漏れは値がゼロになるのではなく、そもそも出力されない形で現れるため、能動的に検査しないと見逃します。
コストの管理も継続的な課題です。開示が集中する時期には処理量が跳ね上がり、費用も比例します。優先度の低い文書は安価な処理に回す、変更のない文書は再処理しないといった制御を入れないと、費用が読めなくなります。文書のハッシュ値で再処理の要否を判定する仕組みを入れてから、費用の変動は落ち着きました。
処理の再現性にも手を入れました。モデルの版が変わると同じ入力に対する出力が変わるため、抽出結果には使用したモデルの版とプロンプトの版を記録しています。過去の分析結果を説明する場面で、この記録がないと何も答えられません。
もう一点、運用に入ってから重みを増したのが処理の順序保証です。開示が集中する時期に並列度を上げると、同じ企業の複数文書が同時に処理され、後から出した文書の結果が先に確定することがありました。企業単位で直列に処理する制御を入れて解消しています。
結果を使う側との対話も、続けてみて必要性が分かった部分です。分析基盤が出す値を運用担当者がどう解釈しているかは、こちらが想定した通りとは限りません。抽出項目の定義を口頭で説明すると認識のずれが残るため、実際の抽出例をいくつか並べて確認する形に変えました。定義は例で共有するほうが早く揃います。
言語モデルの導入で明確に良くなったのは、企業ごとの個別対応が減ったことと、新しい対象を加える立ち上げが速くなったことです。一方で、数値の正確な取り扱い、ラベル定義の曖昧さ、検証の厳密さという難しさは残りました。
実装としては、判定まで委ねず原文の該当箇所の抽出に限定し、抜粋が原文に実在することを検査したうえで位置つきで保存する構成が、いまのところ扱いやすい落としどころです。モデルの選定は公開ベンチマークではなく、自社の文書と項目定義で作った評価セットで判断します。
金融テクノロジー総合研究所では、開示資料の抽出パイプライン、金融特化 LLM の適用設計、検証基盤の構築を受託しています。既存の分析フローの点検からご相談いただけます。お問い合わせよりご連絡ください。
FTL の技術スタックと受託開発の進め方は FTLの技術とは? にまとめています。