金融特化LLMで金融テキスト分析はどう変わったか
言語モデルで楽になった工程と、変わらなかった難しさ。判定まで委ねず、根拠の抽出に限定する構成に落ち着くまでを書きます。
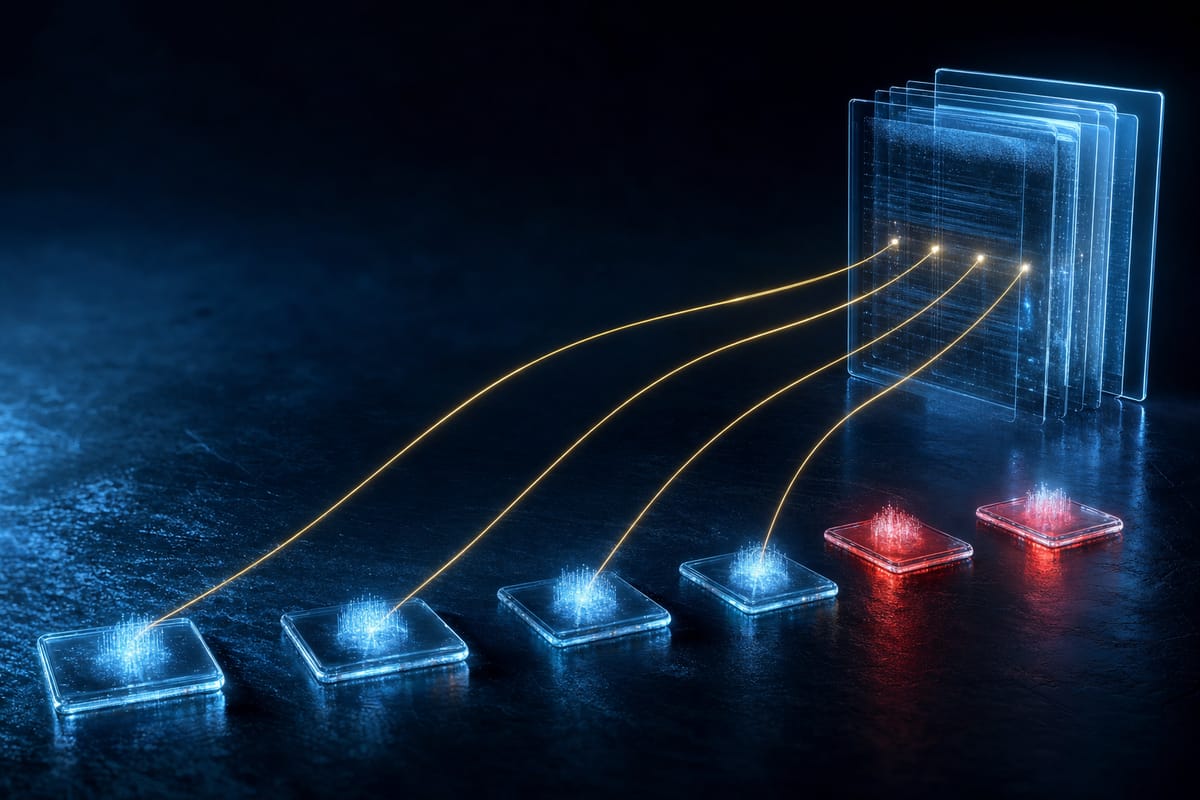
大規模言語モデルを金融業務へ適用するとき、避けて通れないのが事実に基づかない出力の問題です。要約に原文にない数値が現れる、存在しない条項を引用する、根拠として挙げた資料が実在しない。こうした挙動は確率的にテキストを生成するという仕組みに由来するもので、モデルの規模を大きくしても完全には消えません。
重要なのは、この性質を欠陥として排除しようとするのではなく、業務のどこに置けば許容できるかを設計することです。本稿では、金融文書を扱う際に生じやすい誤りの類型と実務的な抑制手段を整理したうえで、金融庁が示している考え方と突き合わせます。参照した一次資料は末尾に列挙しています。
一般的な文章生成と比べて、金融文書では誤りの現れ方に特徴があります。そして類型ごとに、機械的に検出できるかどうかが大きく違います。
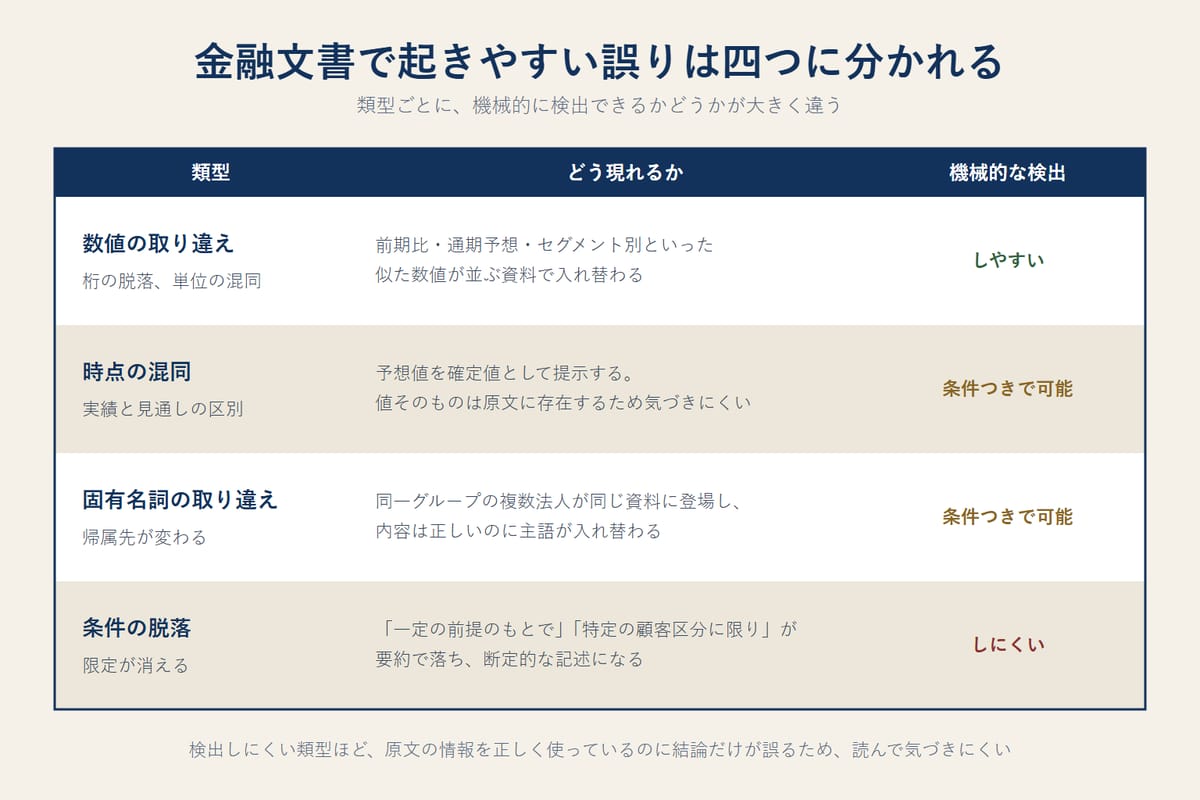
もっとも厄介なのが条件の脱落です。「一定の前提のもとで」「特定の顧客区分に限り」といった限定が要約の過程で落ち、断定的な記述になります。原文の情報は正しく使われているため、出力だけを読んでも誤りだと分かりません。時点の混同や固有名詞の取り違えも同様に、値そのものは原文に存在するため、単純な照合では通り抜けます。
根拠となる文書を検索して与える構成は、無関係な情報の生成を減らす効果があります。ただし、これで問題が解決するわけではありません。検索が適切な箇所を取れなければ、モデルは与えられた不適切な文脈をもとに、もっともらしい誤りを生成します。
この点は評価でも示されています。公開企業の開示資料に関する 10,231 問からなるベンチマーク FinanceBench では、検索の仕組みを組み合わせた当時の最上位モデルでも、人手で確認した標本において誤答または回答拒否が 81% に達したと報告されました。2023年の評価であり、モデルはその後大きく改善していますが、示唆は残ります。検索を足したかどうかではなく、自分たちの文書で測ったかどうかが問題だということです。
金融文書の検索では、表形式のデータをどう扱うかが実装上の難所になります。表をそのまま埋め込みへ変換すると、行と列の対応が失われます。表は構造を保った形で保持し、検索の対象と生成へ渡す形式を分けて扱う必要があります。
もう一つの落とし穴が、資料の版です。過去の資料と最新の資料が同じ検索対象に含まれていると、古い数値を根拠にした回答が生成されます。資料の有効期間を検索条件に含める設計にしておかないと、正しい引用の形をした古い情報が返ります。
実務でもっとも効果があるのは、自由なテキストを生成させないことです。抽出すべき項目を定義し、その形式で出力させたうえで、原文と機械的に照合します。数値については、生成された値が原文中に文字列として存在するかを確認するだけで、取り違えの多くを検出できます。
この照合は完全ではありません。原文の値を組み合わせて計算した結果は照合に失敗しますし、逆に偶然一致する場合もあります。それでも、照合を通らなかった項目を人が確認する運用にすれば、見逃しは大きく減ります。あわせて根拠箇所の提示を必須にし、回答と同時に出典の位置を返させれば、利用者がその場で原文を確認できます。
モデルは、情報が不足している場合でも回答を生成します。これを抑えるには、答えられない場合の振る舞いを明示的に指示し、その選択肢を評価にも含める必要があります。
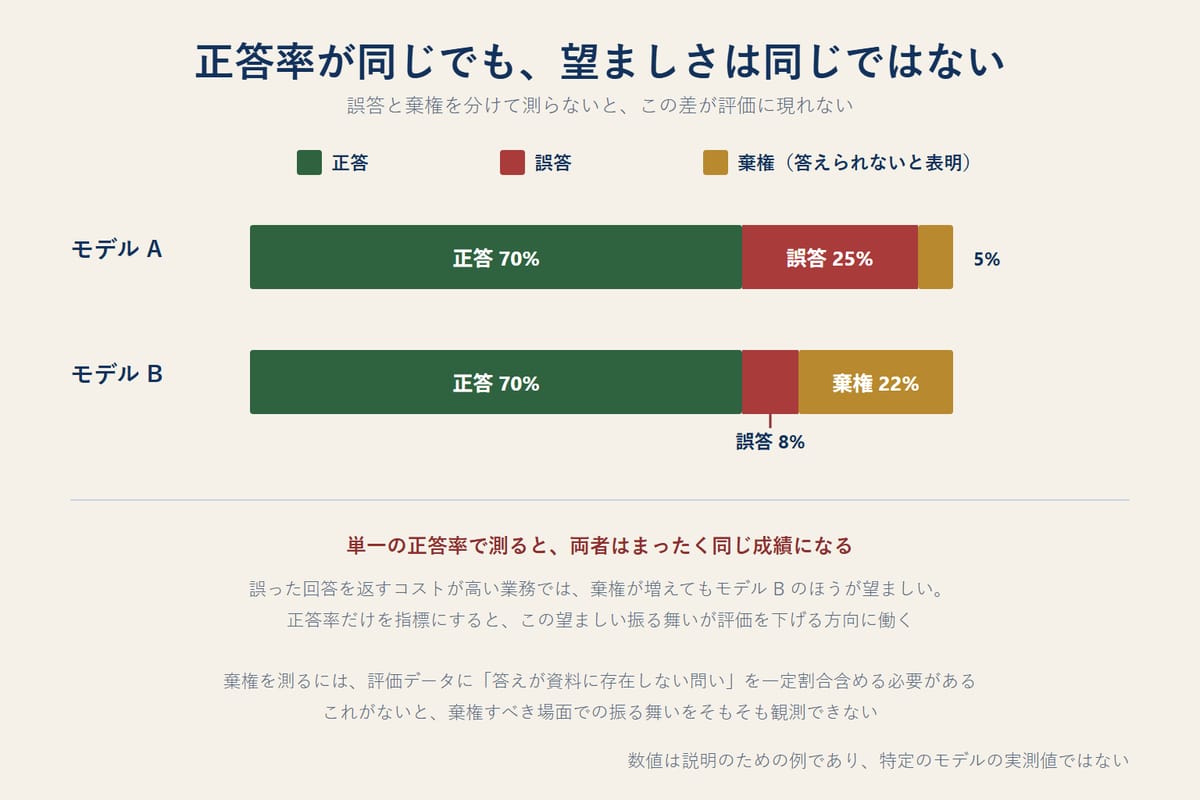
実務的な指標として、正答率だけでなく誤答率と棄権率を分けて測ります。誤った回答を返すコストが高い業務では、棄権が増えても誤答が減るほうが望ましい場合があります。単一の正答率で評価すると、この望ましい振る舞いが評価を下げる方向に働きます。評価用のデータセットには、答えが資料に存在しない問いを一定割合含めます。これがないと、棄権すべき場面での振る舞いを測れません。
抑制策の効果を測るには、自社の業務に即した評価用データが要ります。一般的なベンチマークで良い成績を示しても、扱う文書の種類が違えば挙動は変わります。
作成にあたっては、実際の業務で扱う文書から標本を取り、正解を人手で付与します。労力はかかりますが、数十件規模でも傾向は把握できます。重要なのは件数より、誤りやすい事例を意図的に含めることです。数値が似た項目が並ぶ資料、条件付きの記述が多い資料、そして年度をまたいで数値が改定された資料を優先的に選びます。
評価は一度きりにしません。モデルの更新、プロンプトの変更、検索対象の追加といった変更のたびに回し、以前は正しく答えられていた問いが崩れていないかを確認します。この回帰検査がないと、改善のつもりの変更が別の項目を悪化させたことに気づけません。
金融庁は 2025年3月にAIディスカッションペーパーを公表し、AI官民フォーラムでの議論を反映した第1.1版を 2026年3月3日に公表しています。顧客向けサービスを念頭にしたリスク低減の取組みについて、一定の共通的な目線が形成されつつあるとして、四つの局面に整理されました。
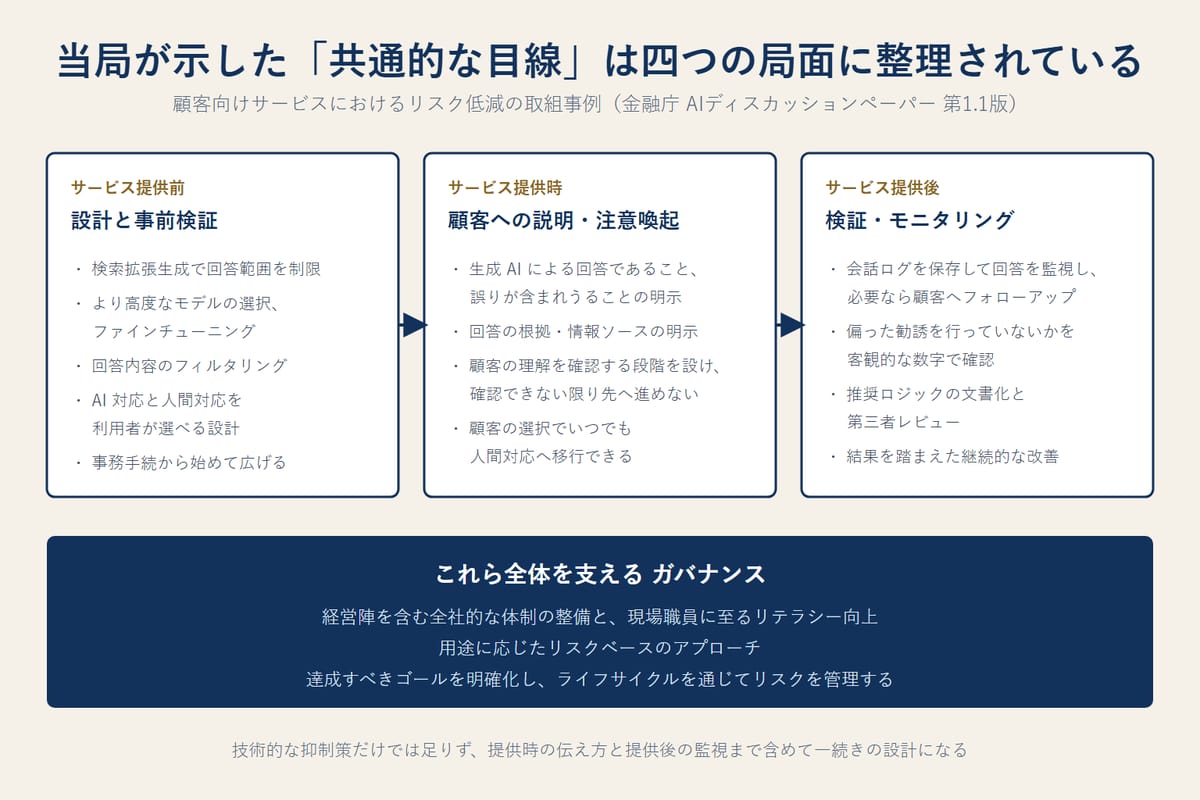
注目したいのは、検索拡張生成やフィルタリングといった技術的な対応が「設計と事前検証」の一項目として置かれている点です。同じ重みで、提供時の説明・注意喚起と、提供後の検証・モニタリングが並びます。とくに顧客の理解を確認する段階を設け、確認できない限り先へ進めないという設計や、いつでも人間対応へ移行できるようにするという項目は、技術ではなく導線の設計です。
提供後については、会話ログを保存して回答を監視し、必要な場合には顧客へフォローアップの連絡を行うこと、偏った勧誘が行われていないかを客観的な数字で確認すること、推奨ロジックを文書化して第三者レビューにかけることが挙げられています。このペーパーは金融機関からの相談・照会に当局が対応する際に参照するものとして整理されており、実装の判断材料になります。
最終的な抑制手段は、責任を伴う判断をモデルに委ねないことです。誤りをゼロにできない以上、誤ったときの影響が小さい工程に配置するのが合理的です。相性が良いのは下読みと絞り込みで、見落としがあっても従来の作業に戻るだけで済みます。
この線引きを考えるうえで有効なのが、誤りが発見されるまでの時間です。すぐに誰かが気づく工程であれば、誤りの影響は限定されます。逆に、誤った内容が記録として蓄積され、後から別の判断の前提として使われる工程では、発見が遅れるほど影響が広がります。誤りの検出可能性を用途選定の基準に加えると、判断がしやすくなります。
組織としては、用途ごとに許容できる誤りの水準を定め、それを満たさない用途には適用しないという線引きを持つことが要ります。試験的な導入で良い結果が出ると適用範囲を広げたいという要望が自然に出てきますが、拠り所となる基準を先に文書化しておかないと、個別の判断の積み重ねで気づかないうちに線を越えます。
運用開始後は、誤りが見つかったときにそれを記録して蓄積する仕組みを用意します。誤り事例の蓄積が、評価データセットの拡充と抑制策の改善の両方に直結します。現場が気づいた誤りを報告する経路がないと、同じ種類の誤りが繰り返されます。
金融領域での言語モデル活用は、幻覚をなくす方向ではなく、誤りが業務判断へ流れ込まない構造を作る方向で設計します。検索拡張は前提として整えたうえで、出力を検証可能な形に制約し、数値と根拠を機械的に照合し、答えられない場合の振る舞いを評価に含める。
そのうえで、当局が整理した四つの局面が示すとおり、技術的な抑制策だけでは足りません。提供時にどう伝えるか、提供後にどう監視するか、それらを支えるガバナンスをどう置くかまでが一続きの設計です。適用は誤りの影響が小さく、検出が早い工程から始めるのが実務的です。
金融テクノロジー総合研究所では、金融特化 LLM の適用設計、検索拡張基盤の構築、出力検証の仕組みづくりを受託しています。用途の切り分けからご相談いただけます。お問い合わせよりご連絡ください。
FTL の技術スタックと受託開発の進め方は FTLの技術とは? にまとめています。